

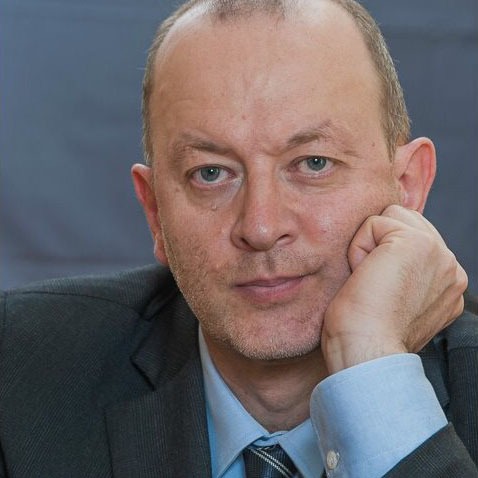
Agostino Clemente, Membro del Comitato IGF Italia ed esperto di Privacy e Diritto delle Nuove Tecnologie, è stato intervistato da Maria Stella De Grandis per l’ Intergruppo Parlamentare Giovani Universitari in Parlamento GUP per un confronto su uno dei temi più urgenti del nostro tempo: il rapporto tra AI, diritti digitali e responsabilità.
L’intelligenza artificiale sta trasformando il nostro modo di vivere, lavorare e interagire con il mondo. Con essa, emergono domande fondamentali su come proteggere i diritti delle persone nell’era digitale: chi controlla i dati? Chi decide con che cosa è lecito addestrare le macchine? Le leggi esistenti sono davvero in grado di tutelare i cittadini?
Per rispondere a queste domande, abbiamo incontrato l’Avv. Agostino Clemente, partner dello studio Ughi e Nunziante, docente di Diritto Industriale presso l’Università degli Studi dell’Aquila e membro del Comitato IGF Italia (Internet Governance Forum), istituito presso il Dipartimento per la Trasformazione Digitale della Presidenza del Consiglio dei ministri. Esperto di proprietà intellettuale, diritto delle nuove tecnologie, privacy e diritto sanitario, l’avvocato Clemente offre una prospettiva lucida e concreta su uno dei temi più urgenti del nostro tempo.
L’intervista
L’intelligenza artificiale può rafforzare la privacy anziché minacciarla?
“Tutte le tecnologie possono essere usate per fare del bene così come per fare del male. La domanda è quindi legittima: sì, l’intelligenza artificiale può rafforzare la privacy, se impiegata responsabilmente. Un esempio recente e significativo riguarda Anthropic, l’azienda che ha sviluppato la piattaforma Claude. Essa ha annunciato di aver sviluppato un nuovo modello particolarmente potente, capace di individuare vulnerabilità nei sistemi informatici finora ritenuti sicuri. La scelta è stata quella di non rilasciarlo immediatamente al pubblico, ma di metterlo prima a disposizione di chi si occupa di difesa informatica, affinché possa sviluppare nuovi strumenti di protezione prima che possano farne uso attori malintenzionati. L’idea, in sostanza, è: diamo prima ai ‘buoni’ la possibilità di difendersi. Ora però la domanda è: cosa accadrà quando soluzioni analoghe verranno sviluppate da aziende meno scrupolose, o da centri di ricerca controllati da stati poco attenti ai profili etici?”
I dati raccolti senza consenso per addestrare i modelli di IA: è un problema giuridico o etico?
“Bisogna innanzitutto fare una distinzione fondamentale: i dati personali e i diritti d’autore sono due profili completamente diversi e non devono essere confusi. I dati personali attengono alla protezione della persona, al diritto all’autodeterminazione informativa. I diritti d’autore riguardano invece la dimensione economica, la tutela patrimoniale delle opere creative.
Per i dati personali, quelli che le persone vogliono mantenere riservati devono essere protetti in modo rigoroso. Allo stesso tempo, però, non possiamo ignorare che in certi contesti (come la ricerca scientifica o la sanità) l’accesso ai dati è indispensabile per il progresso. La soluzione non è bloccare il flusso di informazioni, ma trovare modalità tecniche che permettano di proteggere la riservatezza: pseudonimizzazione, anonimizzazione, dati sintetici, gemelli digitali. Sono strumenti già disponibili che attendono solo una regolazione moderna e adeguata.
Per i diritti d’autore, la logica è diversa. La maggior parte degli autori e dei fornitori di contenuti non vuole che le proprie opere siano nascoste: vuole che circolino, che siano apprezzate, e che da esse derivino riconoscimenti economici. Pensiamo a Spotify: in passato si temeva che le piattaforme musicali avrebbero distrutto l’industria discografica. In realtà, l’hanno trasformata, aumentando enormemente il consumo di musica e creando nuovi meccanismi di remunerazione. Qualcosa di simile dovrebbe avvenire per l’intelligenza artificiale: chi partecipa allo sviluppo contribuendo con contenuti di qualità deve avere accesso a una quota dei proventi generati. Non si tratta di vietare, ma di redistribuire nella logica della solidarietà di filiera.”
Qual è il rischio più concreto per la privacy dei cittadini europei?
“Sorveglianza di massa, profilazione comportamentale e uso commerciale dei dati non sono tre rischi separati: sono tre facce della stessa medaglia. Il problema centrale è la concentrazione del potere di controllo delle informazioni nelle mani di pochi soggetti, oggi prevalentemente privati, in alcuni casi controllati da stati. Questi soggetti non solo ci sorvegliano, ma sono in grado di influenzare i nostri comportamenti. E le informazioni che essi detengono sono esattamente quelle che vorremmo proteggere di più.
Dall’altra parte, la nostra sfera privata è diventata sempre più fragile: viviamo su piattaforme digitali, e spesso non abbiamo piena consapevolezza di cosa sia scritto ‘nei nostri fascicoli’. Questo rischio è sottovalutato: non solo dai cittadini comuni, ma anche dai partiti politici e dai governi. Quando si tratta di condurre una guerra o di affermare un predominio tecnologico su altri stati, la consapevolezza del valore strategico della tecnologia c’è eccome. Ma quando si tratta di tutelare i diritti dei cittadini nel dibattito politico quotidiano, quel tema non trova spazio. Non è che i partiti si confrontino, oggi, su come controllare gli oligopoli tecnologici.”
L’Europa regola davvero le grandi piattaforme? GDPR e AI Act hanno i denti?
“Il GDPR prima e l’AI Act poi hanno rappresentato un’innovazione importante: hanno superato il modello tradizionale delle leggi che stabiliscono divieti generali, introducendo invece una disciplina basata sulla gestione e riduzione del rischio. È l’unico approccio realistico per regolare l’innovazione tecnologica.
Questa impostazione si regge però su due pilastri fondamentali. Il primo è l’accountability: ogni soggetto destinatario delle norme ha l’obbligo di fare del proprio meglio. Non nel senso popolare di ‘faccio quello che posso’, ma nel senso di dover dimostrare di aver fatto tutto il possibile per rispettare le regole e proteggere i diritti. Siamo molto lontani da questa consapevolezza.
Il secondo pilastro è l’esistenza di autorità indipendenti, davvero autonome e dotate delle risorse necessarie. Qui il problema è evidente: le autorità per la protezione dei dati non hanno le risorse per intervenire efficacemente. E in Italia, per quanto riguarda l’intelligenza artificiale, non esiste nemmeno un’autorità indipendente: la competenza è stata assegnata a due agenzie governative. Ma il governo è uno dei soggetti che le norme dovrebbero controllare: è chiaro che manca l’indipendenza necessaria.”
Quale dovrebbe essere la priorità assoluta del legislatore italiano ed europeo nei prossimi cinque anni?
“Una sola priorità non basta. Ne indicherei almeno due.
La prima riguarda la concentrazione del potere tecnologico. È necessario intervenire sui gatekeeper , quei grandi soggetti che controllano le infrastrutture digitali , e farlo in modo proattivo, anticipando i problemi anziché rincorrerli. Un esempio virtuoso è l’indagine conoscitiva avviata dall’AGCM sulla concentrazione di potere computazionale nel quantum computing: un’iniziativa insolita, perché di solito gli stati arrivano quando ‘i buoi hanno già lasciato la stalla da un pezzo’. Il quantum computing richiede investimenti enormi, e il rischio concreto è che la capacità computazionale si concentri nelle mani di pochissimi soggetti privati, che la metteranno a disposizione degli altri secondo le proprie regole. Se non interviene una regolazione adeguata, e non solo nazionale, ma necessariamente transnazionale, il problema sarà enormemente amplificato.
La seconda priorità è la formazione digitale. In pochi anni rischiamo di vedere il mondo diviso tra chi sa usare la tecnologia e chi ne è escluso, con conseguenze drammatiche per l’occupazione, per la competitività delle imprese, per la partecipazione democratica. Non è vero che la tecnologia sostituirà le persone: le persone verranno sostituite dalle persone che sapranno trarre vantaggio dalla tecnologia. Bisogna investire in piani formativi seri nelle scuole, nelle università, nelle aziende, e tra chi cerca lavoro. E soprattutto bisogna misurare l’efficacia di questa formazione: non si tratta di organizzare corsi, si tratta di garantire che le persone imparino davvero.”
L’intervista all’Avv. Clemente offre una lettura articolata e competente di un tema che riguarda tutti noi. Le sfide poste dall’intelligenza artificiale ai diritti fondamentali sono reali e meritano più attenzione di quanta ne ricevano oggi, sia nel dibattito pubblico sia nelle sedi istituzionali.Le leggi esistono, alcune sono anche innovative, ma rischiano di rimanere lettera morta senza autorità davvero indipendenti, senza risorse adeguate e senza una cultura diffusa dell’accountability.
La distinzione tra protezione dei dati personali e tutela del diritto d’autore, spesso confusi nel dibattito pubblico, è fondamentale per costruire soluzioni normative efficaci. E la strada non passa per i divieti, ma per la regolazione intelligente dei flussi di informazione, che sappia proteggere le persone senza bloccare il progresso scientifico e tecnologico.
Il messaggio più urgente che emerge da questa conversazione è forse il più semplice: la tecnologia cammina sulle spalle delle persone. Se non investiamo sulla formazione digitale concreta, misurabile, capillare, il rischio non è che le macchine ci sostituiscano, ma che siano le persone più competenti a farlo. E quel divario, una volta aperto, sarà difficile da colmare.
Leggi l’intervista sul blog dell’Intergruppo Parlamentare Giovani Universitari in Parlamento GUP.